RAG-поиск состоит из подготовки содержимого, извлечения релевантных фрагментов и генерации ответа на их основе. Диагностическая таблица помогает отдельно проверить, был ли документ обработан, нашёлся ли нужный фрагмент, разрешён ли к нему доступ и подтверждает ли он итоговую формулировку.
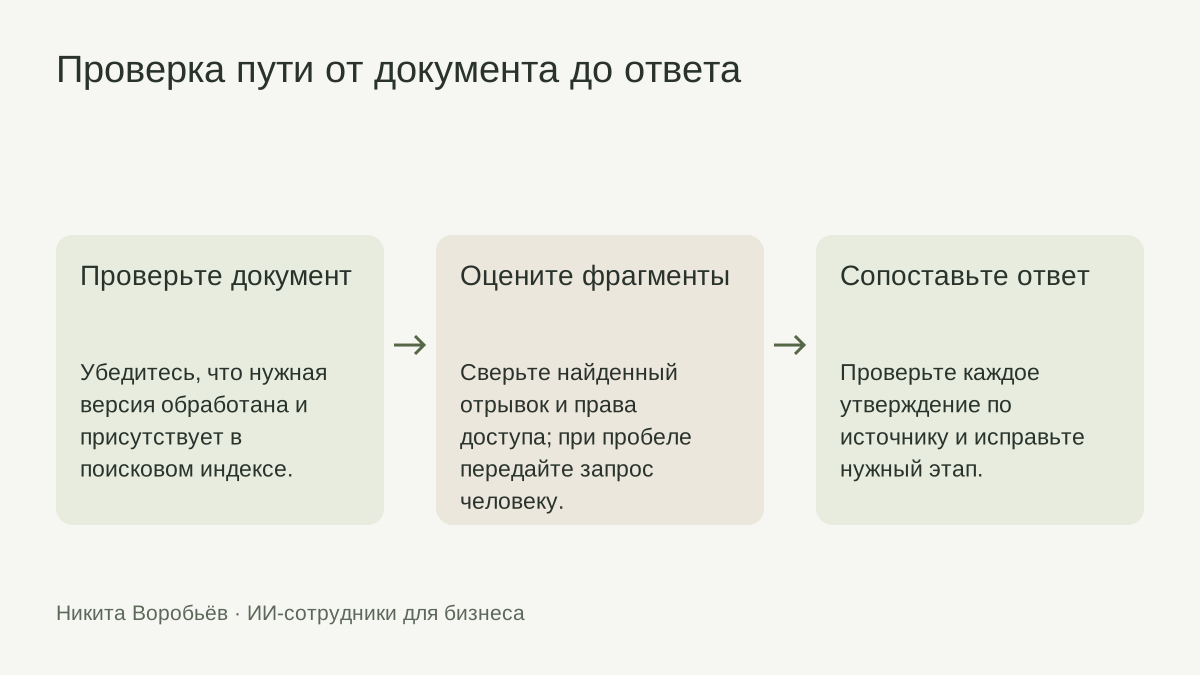
Краткий ответ: если ИИ не находит ответ в базе знаний, проверьте весь путь от документа до сформированного текста. Сначала выясните, попал ли документ в поиск, затем — был ли найден нужный фрагмент, разрешён ли он этому пользователю и подтверждает ли его содержание ответ. Такой порядок отличает пробел в материалах от ошибки поиска и ошибки генерации.
Из каких этапов состоит RAG-поиск
RAG — это схема, при которой система извлекает релевантные сведения из документов компании и передаёт найденный контекст языковой модели для подготовки ответа. В реализации Microsoft Azure AI Search документы индексируются, система получает подходящие фрагменты, а затем модель формирует ответ на основе этих данных. У конкретных платформ есть собственные настройки и механизмы, поэтому это объяснение описывает общую цепочку, а не универсальное устройство каждой системы. Обзор RAG в Azure AI Search показывает связь поиска, фрагментов и генерации.
Для диагностики разделите цепочку на этапы: исходный документ, извлечённый текст, разбиение на фрагменты, индекс, результаты поиска, фильтры доступа, контекст модели и итоговый ответ. Если смотреть только на финальный текст, трудно понять, возникла проблема в документе или модель сформулировала его неправильно.
Найдите место, где потерялся ответ
| Что наблюдаете | Что проверить | Вероятная зона ошибки |
|---|---|---|
| Документ отсутствует в источниках | Его актуальность, формат, загрузку и обработку | Подготовка или индексация |
| Документ есть, но поиск его не возвращает | Индекс, формулировку запроса, синонимы и фильтры | Извлечение фрагментов |
| Найден соседний, но неподходящий раздел | Заголовки, границы разбиения и релевантность результата | Настройка фрагментов и поиска |
| Нужный отрывок есть, ответа всё равно нет | Достаточность контекста и инструкцию модели | Формирование ответа |
| Ответ опирается на старую версию | Метаданные, обновление и исключение архивов | Версии и актуальность |
Попросите систему показать диагностический результат: текст запроса, выбранные фрагменты, название исходного документа, дату или версию источника, применённые фильтры и итоговый текст. Эти поля могут быть представлены по-разному в разных продуктах. Важно, чтобы ответственный мог проверить, откуда взялось утверждение.
Проверьте, как документ разделён на части
Большой файл обычно делят на более короткие фрагменты, которые система ищет и передаёт модели. Если разрезать документ без учёта заголовков, таблиц и соседних пояснений, определение может отделиться от условий, а таблица — потерять подписи столбцов. Слишком крупный фрагмент тоже мешает: в контекст попадает много материала, не относящегося к вопросу.
Нет одного размера фрагмента, подходящего для всех документов. Начните с анализа структуры: сохраняйте название раздела, связь с таблицей и единицы измерения. Затем возьмите вопросы из обращений и сравните, какие части система находит. Microsoft отдельно описывает разбиение больших документов для векторного поиска и RAG; рекомендации относятся к возможностям Azure AI Search и помогают понять практические компромиссы. Руководство Microsoft по разбиению документов.
Проверьте документы с похожими темами и разными условиями. Например, действующая цена и архивное предложение могут содержать одинаковые слова, но иметь разную актуальность. Метаданные о продукте, подразделении, версии и дате помогают применить фильтр и выяснить источник. Если данные разделены по правам, тестируйте поиск от имени пользователей с разным доступом.
Отделите ошибку извлечения от ошибки ответа
Если поиск не вернул нужный текст, переписывание инструкции модели не добавит отсутствующий фрагмент. Проверьте запросы в нескольких формулировках, словарь терминов клиента, настройку фильтров и состояние индекса. Если документ найден, но ответ неверно его пересказывает, сравните конкретные утверждения с извлечённым текстом.
Для каждого проверочного вопроса зафиксируйте ожидаемый источник и важные факты, которые должны попасть в ответ. Отдельно проверьте вопрос, на который в базе нет ответа. В такой ветке помощник должен обозначить нехватку сведений, уточнить запрос или передать его сотруднику. Наличие RAG снижает зависимость ответа от одних лишь общих знаний модели, но не гарантирует, что поиск вернёт правильный фрагмент или что ответ будет точным.
Подготовка самих документов раскрыта в материале о базе знаний, а порядок проверки готового ИИ-сотрудника — в руководстве по контролю качества.
Чек-лист диагностики
- Исходный документ актуален и попал в индекс.
- Текст извлечён полностью, таблицы и заголовки сохранены.
- Версия, дата и владелец источника доступны для проверки.
- Тестовый вопрос соответствует реальному обращению, а не только формулировке документа.
- В результатах поиска видны выбранные фрагменты и их источник.
- Фильтры доступа проверены для разных ролей.
- Ответ сверяется с найденным фрагментом, включая ограничения и исключения.
- Для отсутствующего ответа задан безопасный переход к уточнению или человеку.
Ограничения и следующий шаг
RAG не исправляет устаревший или противоречивый документ, а релевантный фрагмент может не содержать всей нужной оговорки. Результат зависит от подготовки материалов, поиска, фильтров и модели. Поэтому не сообщайте пользователю, что ответ найден в источнике, пока приложение не проверило сам источник и не показало результат поиска.
Для обсуждения внедрения подготовьте несколько вопросов, ожидаемые документы и примеры ошибочных ответов. По ним можно определить, какой этап поиска требует внимания, и спроектировать проверяемый маршрут на странице внедрения.
Частые вопросы
Почему ИИ может не найти ответ, хотя нужный документ есть?
Документ мог не попасть в индекс, нужный фрагмент мог потеряться при обработке, а запрос или фильтр — не совпасть с поисковой настройкой.
Устраняет ли RAG выдуманные ответы полностью?
Нет. Он добавляет поиск по источникам, но найденные фрагменты могут быть неполными или нерелевантными, а генерация всё равно требует проверки.
Никита Воробьёв
Внедряю ИИ-сотрудников для чатов, мессенджеров и телефонной первой линии.
Обновлено: . Как устроены материалы
О моём подходе